Нейросети для Excel и таблиц: как ускорить работу с данными
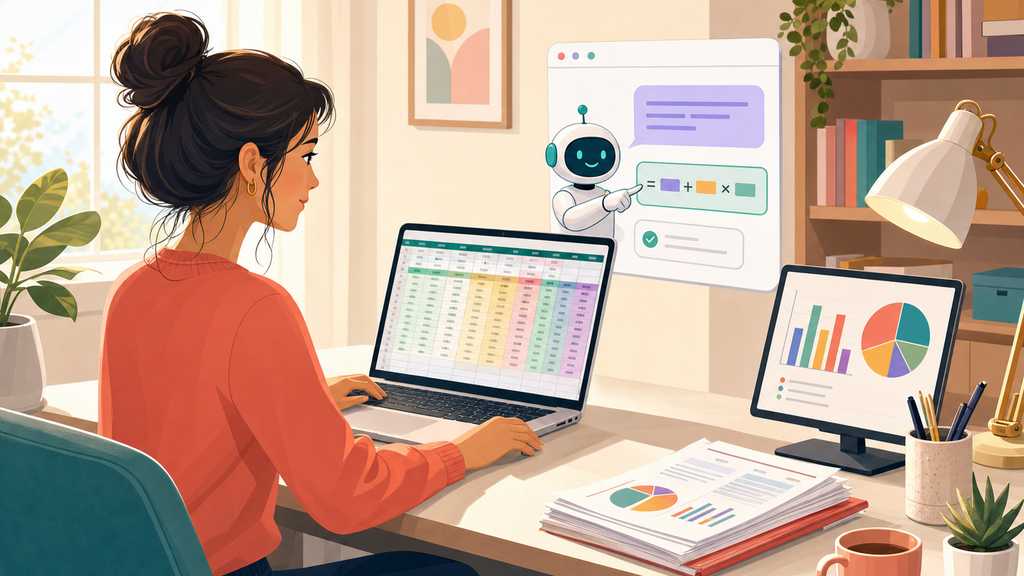
Когда я впервые попробовал подключить нейросеть к работе с таблицами, я ждал волшебства: загружаю файл, а на выходе готовый отчёт с выводами. Реальность оказалась интереснее и проще одновременно — волшебства не случилось, но рутины стало заметно меньше уже в первый вечер, и это меня убедило продолжать.
Таблицы — самый недооценённый способ применения искусственного интеллекта. Все обсуждают картинки и тексты, а между тем огромная часть рабочего времени уходит на формулы, выгрузки, сверки, поиск дублей и сведение цифр в аккуратный вид. Именно здесь нейросеть экономит часы, а не минуты.
В этой статье я собрал свой практический опыт: как передавать данные в чат, какие формулы просить, как чистить справочники, как получать выводы и как не наловить ошибок. Всё проверено на обычных рабочих файлах, без специальных надстроек и без программирования.
Сразу договоримся о терминах. Под таблицами я понимаю привычные Excel и Google Таблицы, а под нейросетью — обычный чат-бот с текстовым интерфейсом. Никаких макросов, скриптов и платных плагинов: только копирование данных туда и обратно, плюс ваша голова на месте.
Такой подход работает почти на любом компьютере и не требует подписки на дорогие сервисы. Даже бесплатной версии чат-бота хватает, чтобы разобраться с формулами, привести в порядок список клиентов или собрать черновик отчёта для руководства.
Главное правило, которое я вывел за месяцы такой работы: нейросеть не заменяет таблицу, она работает рядом с ней. Вы остаётесь хозяином файла, а ИИ становится терпеливым помощником, который объясняет, подсказывает и делает черновую работу.
Ещё одно наблюдение: чем конкретнее вы описываете задачу, тем меньше правок приходится вносить. Фраза «сделай красиво» не работает почти никогда, а фраза «нужно найти всех клиентов из Казани, у которых не было заказов больше двух месяцев» работает почти всегда.
Дальше я разберу всё по шагам: от подготовки данных до готового отчёта, с примерами формул и формулировок, которые можно копировать и адаптировать под себя. Материал рассчитан на новичков, но, надеюсь, опытные пользователи тоже найдут пару приёмов.
Если вы раньше не работали с ИИ, читайте по порядку: каждый раздел опирается на предыдущий. Если уже что-то пробовали, можно переходить к частям про формулы, чистку данных и отчёты — там самое практичное и быстро окупаемое.
Зачем нейросети в таблицах: что они реально умеют
Нейросеть умеет читать вашу таблицу, понимать смысл колонок и предлагать решение на человеческом языке. Это звучит просто, но именно это качество экономит время: вы не ищете формулу по форумам и не вспоминаете синтаксис, а описываете задачу и получаете готовый вариант с пояснением.
При этом ИИ не считает данные сам по себе — он не открывает ваш файл и не видит, что изменилось после правок. Все вычисления происходят в таблице, а нейросеть лишь подсказывает, как их выполнить. Понимание этого различия спасает от большинства разочарований.
Проще говоря, вы получаете переводчика между своей задачей и инструментом. Чем лучше вы формулируете задачу, тем точнее перевод. И чем аккуратнее подготовлены данные, тем меньше времени уходит на исправление результата.
Чем ИИ помогает, а чем не помогает
Хорошо нейросеть справляется с объяснением. Спросите, что делает функция, почему формула возвращает ошибку, чем отличается один способ поиска от другого — и получите разбор простыми словами. Для новичка это как личный преподаватель, который не устаёт повторять.
Отлично работает генерация формул по описанию задачи. Вы рассказываете, какие колонки есть и что нужно получить, а ИИ предлагает формулу и объясняет логику. Даже если вариант не идеален, он даёт отправную точку, которую легко доработать.
Сильная сторона — работа с текстом внутри таблиц. Разобрать ФИО на части, вытащить город из адреса, привести названия компаний к единому виду, найти закономерность в комментариях клиентов — всё это нейросеть делает быстро и почти без ошибок.
А вот считать она не любит и не умеет надёжно. Если попросить «посчитай сумму по этой колонке», модель может ошибиться в арифметике или придумать правдоподобное число. Считать должна таблица, а ИИ — объяснять, что и как посчитать.
Не стоит ждать от неё и полной автоматизации. Она не подключится к вашей базе, не обновит данные ночью и не заметит, что вчерашняя выгрузка пришла с другими заголовками. Всё, что связано с доступом к файлам и расписанием, остаётся на вас или на отдельных инструментах.
И последнее: нейросеть не знает контекст вашего бизнеса. Что такое «хороший клиент», какие скидки допустимы, какие цифры считаются нормой — это вы объясняете сами. Чем больше вводных вы дадите, тем полезнее будет ответ.
Какие инструменты подойдут
Начать проще всего с обычного чат-бота в браузере. Подойдёт любой популярный сервис: главное, чтобы он принимал текст и умел работать с длинными сообщениями. Для большинства задач хватает бесплатного тарифа, особенно если не загружать файлы целиком.
У ChatGPT, Claude и Gemini есть возможность прикреплять файлы таблиц. Это удобно для первичного анализа: модель читает структуру, находит закономерности и отвечает на вопросы по данным. Но проверять её выводы всё равно нужно вручную.
В Excel есть встроенный помощник, который умеет предлагать формулы и строить сводки прямо в интерфейсе. В Google Таблицах похожие функции тоже появляются, хотя работают они по-разному в зависимости от тарифа и региона. Это удобно, но не обязательно.
Отдельная категория — надстройки и плагины, которые соединяют таблицу с моделью напрямую. Они экономят клики, но требуют доступа к данным и часто платные. Я бы советовал сначала освоить простой копипаст, а уже потом думать об автоматизации.
Для работы с большими выгрузками пригодится промежуточный шаг: сохранить файл в CSV, открыть его в таблице и передавать модели только нужный фрагмент. Так вы контролируете, какие данные покидают ваш компьютер, и не упираетесь в ограничения по размеру сообщения.
Мой рабочий набор выглядит скромно: браузер с чат-ботом, Excel для расчётов и текстовый файл с заготовками формулировок. Этого достаточно, чтобы закрывать большинство задач, с которыми я сталкиваюсь в обычной работе с данными.
Подготовка данных: что и как передавать в чат
Качество ответа почти всегда зависит от качества входных данных. Если вы скопируете в чат десять строк без заголовков, модель начнёт догадываться, что где находится, и догадается не всегда верно. Пять минут подготовки экономят полчаса переделок.
Первым делом уберите из выгрузки всё лишнее: пустые колонки, служебные поля, повторяющиеся блоки. Модель плохо переносит визуальный шум и может принять пустую колонку за значимую, а потом строить на ней выводы, которые ни к чему не относятся.
Затем приведите в порядок заголовки. Короткие понятные названия вроде «дата заказа», «сумма», «город» работают лучше, чем «Поле 12» или длинные фразы из учётной системы. Если заголовков нет, добавьте их сами — это займёт минуту.
Что копировать: диапазон, заголовки, типы
Копируйте только нужный диапазон, а не весь лист целиком. Если задача касается продаж за квартал, незачем отправлять данные за три года. Чем меньше лишнего, тем быстрее ответ и тем выше шанс, что модель не запутается в объёме.
Всегда включайте строку заголовков. Это единственный способ, которым модель понимает смысл колонок, не задавая уточняющих вопросов. Без заголовков она будет вынуждена угадывать, а угадывание в работе с цифрами — плохая стратегия.
Обращайте внимание на типы данных. Даты в формате «17.10.2026» и «2026-10-17» выглядят для человека почти одинаково, а для формулы — совершенно по-разному. Приведите колонку к одному формату до того, как просить формулу.
Числа с разделителями разрядов и знаками валюты тоже стоит почистить. Символ рубля или пробел внутри числа превращает значение в текст, и любая арифметика по такой колонке даст нули или ошибку. Уберите оформление, оставьте чистые числа.
Если строк много, передавайте выборку: первые двадцать строк как образец плюс отдельно описание полного объёма. Для генерации формулы этого достаточно, а для анализа закономерностей лучше подойдёт агрегированная таблица, а не сырая выгрузка.
Полезно сразу указывать, что означает каждая колонка, если название неочевидно. Одна фраза «в колонке C указана сумма без НДС, в колонке D — с НДС» снимает половину возможных ошибок и делает ответ гораздо точнее.
Обезличивание данных и безопасность
Прежде чем отправлять таблицу в чат, подумайте, что в ней лежит. Телефоны, адреса, паспортные данные, номера договоров — всё это не стоит передавать во внешний сервис без необходимости. Замените реальные значения на условные.
Простой приём: скопируйте данные в новый лист и замените имена на «Клиент 1», «Клиент 2», телефоны на последовательные номера. Структура сохранится, логика задачи тоже, а персональные данные останутся у вас.
Если задача требует именно реальных значений, используйте сервисы с понятной политикой хранения и возможностью отключить обучение на ваших данных. Это особенно важно, если вы работаете с коммерческой информацией или данными клиентов.
Проверьте настройки аккаунта: во многих сервисах есть переключатель, который запрещает использовать переписку для тренировки моделей. Включить его стоит один раз, а спокойствия он добавляет надолго.
Не отправляйте файлы целиком, если можно отправить фрагмент. Не храните в переписке доступы и пароли. Не просите модель «запомнить» конфиденциальные данные — она этого не умеет в нужном вам смысле, а след в истории останется.
И самое простое правило: если информацию нельзя показать коллеге из другого отдела, её точно не стоит вставлять в чат с внешней моделью. Здравый смысл здесь работает лучше любых технических ограничений.
Формулы, которые раньше казались сложными
Формулы — та часть работы с таблицами, где нейросеть даёт самый быстрый результат. Вам не нужно помнить синтаксис и порядок аргументов: достаточно описать задачу словами и указать, какие колонки участвуют. Дальше остаётся вставить формулу и проверить.
Я пользуюсь простым шаблоном запроса: сначала описываю структуру таблицы, затем формулирую, что нужно получить, затем прошу объяснить решение по шагам. Такой запрос почти всегда возвращает рабочую формулу, а не абстрактный пример.
Если формула возвращает ошибку, не начинайте заново. Скопируйте текст ошибки и саму формулу в чат и попросите найти причину. В девяти случаях из десяти проблема в типе данных, лишних пробелах или неверной ссылке на диапазон.
Поиск по нескольким условиям
Классическая задача: найти в справочнике значение по двум признакам одновременно. Раньше для этого приходилось собирать вспомогательные колонки, теперь достаточно описать условие и получить формулу с ИНДЕКС и ПОИСКПОЗ или современный XLOOKUP.
Формулируйте так: «есть лист с заказами, колонка A — номер клиента, B — месяц, C — сумма. На другом листе нужно найти сумму для клиента из ячейки A2 и месяца из B1». Этого описания достаточно, чтобы модель собрала точную ссылку.
Обязательно уточните, что должно происходить, если совпадений нет. Пустая ячейка, ноль или текст «не найдено» — это три разных поведения, и модель выберет первое, что придёт в голову, если вы не скажете явно.
Для поиска по частичному совпадению просите решения с поиском подстроки. Например, найти все строки, где в названии компании встречается «торг». Это частая задача при сверке справочников, и нейросеть решает её уверенно.
Отдельно проверьте регистр и пробелы. «ООО Ромашка» и «ООО ромашка» для формулы разные значения, поэтому в запросе стоит сразу попросить учесть это и добавить соответствующую обработку.
Когда формула найдена, сохраните её в отдельный файл с пояснением. Через месяц вы не вспомните, почему там три вложенных условия, а короткая заметка сэкономит вам время и нервы.
Текст и даты: разбор ФИО, адресов, артикулов
Разбор текстовых колонок — задача, которую без ИИ делают вручную или сложными формулами. ФИО, адреса, артикулы, названия товаров с характеристиками — всё это можно разделить на части за один запрос.
Начните с образца. Покажите десять строк и скажите, что нужно получить: фамилию в отдельной колонке, имя в другой, отчество в третьей. Модель предложит формулу, которая обрабатывает и обычные случаи, и двойные фамилии.
С адресами сложнее: формат гуляет, бывают сокращения, бывают лишние элементы вроде индекса в начале строки. Здесь хорошо работает комбинация формул и ручной проверки: ИИ даёт черновик, вы просматриваете спорные строки.
Даты требуют отдельного внимания. Попросите формулу, которая приводит текст к дате и корректно обрабатывает пустые значения. Заодно уточните, как быть с датами в будущем и с очевидными опечатками вроде тридцать второго числа.
Для артикулов полезно просить извлечение по маске: первые три символа — категория, следующие четыре — номер, последние два — вариант. Такая формула заменяет долгую ручную разметку и работает одинаково для всей колонки.
После любого разбора текста сделайте контрольную выборку: отфильтруйте пустые результаты и посмотрите, что осталось. Обычно там оказываются строки с нестандартным форматом, и именно они требуют вашего внимания.
Чистка данных: дубли, форматы, лишние пробелы
Чистка данных — самая скучная и самая важная часть работы. От неё зависит, сойдутся ли итоги, не потеряются ли клиенты и не придётся ли переделывать отчёт перед встречей. Нейросеть здесь работает как ускоритель, а не как замена внимания.
Начинайте с диагностики. Попросите модель посмотреть на образец данных и перечислить возможные проблемы: разные написания одного и того же значения, лишние пробелы, пустые строки, несоответствия форматов. Свежий взгляд помогает заметить то, к чему вы привыкли.
Дальше действуйте по одной проблеме за раз. Если взяться за всё сразу, легко запутаться в формулах и потерять исходные данные. Я обычно сохраняю копию листа перед каждым этапом и подписываю её датой.
Приведение справочников к единому виду
Самый частый случай: в колонке городов встречается «Москва», «москва», «Москва г.», «г Москва». Для человека это одно и то же, для сводной таблицы — четыре разных города. Приводить к единому виду нужно до анализа.
Попросите модель составить список уникальных значений и предложить правило замены. Затем сгенерируйте формулу или последовательность действий, которая применяет правило ко всей колонке. Проверьте результат на десяти случайных строках.
С названиями компаний работают похожие приёмы: убрать кавычки, сокращения и лишние пробелы, привести к единому регистру. Если в справочнике есть ИНН, лучше сверяться по нему, а не по названию — это надёжнее.
Для телефонов и почты просите проверку формата. Модель подскажет формулу, которая отмечает подозрительные значения: слишком короткие, с буквами, без кода страны. Такая проверка ловит опечатки ещё до рассылки.
Не забывайте про пробелы в начале и конце строки. Они невидимы, но ломают поиск и сравнение. Одна формула с очисткой пробелов решает проблему, и делать это стоит сразу после выгрузки.
Если справочник большой, разбейте работу на части: сначала города, потом компании, потом контакты. Так вы контролируете каждый шаг и можете остановиться, если что-то пошло не так, не переделывая весь файл.
Поиск дублей и «грязных» строк
Дубли в списке клиентов — тихая проблема, которая портит отчёты месяцами. Два контакта одного человека с разными написаниями выглядят как два клиента, и статистика начинает врать. ИИ помогает найти такие пары по нечёткому совпадению.
Опишите модели, что считается дублем: одинаковый телефон, похожее имя и та же компания. Попросите формулу, которая помечает подозрительные строки, а затем просмотрите помеченные вручную — окончательное решение всегда за вами.
Полезно просить не только пометку, но и пояснение: почему строка попала в список подозрительных. Это ускоряет проверку и помогает понять, не слишком ли агрессивно настроено правило.
Отдельная категория — строки-пустышки: только имя без контактов, только телефон без имени, записи с датой из будущего. Их стоит вынести в отдельный список и разобрать отдельно, а не смешивать с рабочими данными.
После чистки сохраните журнал изменений: что удалили, что объединили, что исправили. Через полгода этот файл спасёт вас от споров о том, куда пропал клиент и почему изменилась сумма.
И не удаляйте исходник. Даже если кажется, что он больше не нужен, оставьте копию на месяц. Ошибки в чистке обнаруживаются не сразу, а восстановить данные из ниоткуда невозможно.
Анализ данных: от цифр к выводам
Когда данные чистые, начинается самое интересное — анализ. Нейросеть здесь не считает, а помогает думать: подсказывает, какие срезы посмотреть, какие вопросы задать к цифрам и что может скрываться за странностями в отчёте.
Я использую её как собеседника. Формулирую гипотезу, прошу проверить, какие данные её подтвердят или опровергнут, и получаю список конкретных шагов. Дальше строю сводную таблицу и смотрю на результат своими глазами.
Это важный момент: ИИ предлагает направление, а не выдаёт истину. Он может подсказать, что стоит сравнить продажи по регионам, но само сравнение должно быть построено на ваших реальных данных и проверено вами.
Сводные таблицы и группировка
Сводная таблица — главный инструмент анализа, и нейросеть хорошо помогает её настроить. Опишите, что хотите увидеть: выручку по месяцам в разрезе категорий, количество заказов по менеджерам, средний чек по городам.
Просите не только инструкцию, но и объяснение, какие поля куда положить. «В строки — месяц, в столбцы — категория, в значения — сумма» — это тот уровень конкретики, который даёт предсказуемый результат с первого раза.
Если сводная таблица не строится или выдаёт странные итоги, причина почти всегда в данных: текст вместо чисел, пустые значения, лишние итоговые строки внутри диапазона. Проверьте это до того, как винить инструмент.
Полезно сразу просить несколько вариантов группировки: по месяцам, по кварталам, по неделям. Разный шаг времени показывает разные закономерности, и иногда недельная картина говорит больше, чем месячная.
Для сравнения периодов попросите добавить вычисляемое поле с разницей или процентом изменения. Такой столбец превращает скучную таблицу в понятную картину роста или падения, и на его основе проще делать выводы.
Не забывайте про сортировку и фильтры. Модель может подсказать, как быстро выделить топ-10 и хвост, и это часто важнее, чем полный список из сотен строк, в котором никто не станет разбираться.
Как задавать вопросы к данным
Хороший вопрос к данным звучит как проверяемая гипотеза, а не как просьба «проанализируй всё». Вместо «что не так с продажами» спросите «в каких регионах средний чек упал сильнее всего за последние три месяца и какие категории это объясняют».
Давайте модели контекст: что означает успех, какие колебания нормальны, какие события могли повлиять. Без этого она будет оценивать данные в вакууме и выдавать общие рекомендации, которые вы и так знаете.
Просите несколько версий ответа: консервативную, оптимистичную и «а что если данные неполные». Такой приём помогает увидеть риски, о которых вы не подумали, и заранее подготовить ответы на неудобные вопросы.
Отдельно спрашивайте про ограничения анализа. Какие выводы делать нельзя, какие данные отсутствуют, что может исказить картину. Честный список ограничений часто полезнее самого вывода.
Если модель выдаёт слишком общие формулировки, сужайте вопрос. «Почему упали продажи» — плохой вопрос. «Почему упали продажи в категории товаров для дома в июле по сравнению с июнем» — вопрос, на который можно ответить данными.
Записывайте удачные вопросы. Через месяц у вас появится личный список проверок, который можно прогонять по каждому новому отчёту, и это сильно ускоряет работу.
Отчёт из таблицы за полчаса
Отчёт — это не таблица, а история о том, что в таблице происходит. Нейросеть помогает собрать эту историю: выделить главное, сформулировать выводы, предложить структуру и написать текстовые пояснения понятным языком.
Я делаю так: сначала готовлю сводку с ключевыми цифрами, затем передаю её модели вместе с контекстом и прошу собрать черновик отчёта. Дальше правлю формулировки и проверяю каждую цифру по исходным данным.
Такой подход экономит не столько на написании, сколько на структуре. Пустой лист — главный враг отчёта, а готовый каркас снимает ступор и позволяет сразу перейти к содержанию.
Структура отчёта, которую собирает ИИ
Попросите модель предложить структуру под конкретного читателя. Отчёт для руководителя и отчёт для команды — разные документы: первому нужны выводы и решения, второму — детали и задачи. Одна и та же сводка превращается в два разных текста.
Рабочий каркас выглядит так: короткое резюме на три предложения, ключевые показатели, что изменилось и почему, риски, что предлагается сделать дальше. Этого достаточно для большинства регулярных отчётов.
Обязательно просите писать резюме последним. Модель, которая сначала формулирует выводы, а потом подгоняет под них детали, ошибается чаще. Логичнее сначала описать факты, а затем сжать их в три предложения.
Отдельно попросите список вопросов, на которые отчёт не отвечает. Это подскажет, какие данные стоит добавить в следующий раз, и постепенно превратит шаблон в полноценную систему отчётности.
Проверьте, нет ли в тексте оценочных суждений без опоры на данные. Фразы вроде «значительно выросли» звучат красиво, но без цифры рядом они ничего не значат и вызывают недоверие у читателя.
Хороший отчёт заканчивается конкретным следующим шагом. Не «продолжим наблюдать», а «проверим причины падения в двух регионах и вернёмся с предложением». Модель легко напишет такой финал, если вы попросите.
Графики и визуализация: что просить
По данным из таблицы нейросеть подскажет, какой тип графика подойдёт: линия для динамики, столбцы для сравнения категорий, круговая диаграмма для структуры. Сама она картинку не нарисует, но выбор подскажет точно.
Просите обоснование выбора. «Почему линия, а не столбцы» — полезный вопрос, потому что ответ объясняет логику восприятия и помогает в следующий раз выбрать самостоятельно.
Отдельно спрашивайте, что убрать с графика. Лишние подписи, второстепенные ряды, десять цветов — всё это мешает читателю. Минимализм в визуализации почти всегда выигрывает.
Если график должен убеждать, попросите аккуратно выделить главное: один ряд цветом, остальные серым, подпись у ключевой точки. Такие детали делают картинку понятной без устных пояснений.
Не просите модель нарисовать диаграмму текстом. Это почти всегда выглядит плохо и тратит время. Лучше получить инструкцию и построить график в таблице за пару минут.
И проверяйте масштаб. Обрезанная ось или неверный шаг могут превратить небольшое колебание в драматический обвал. Такие ошибки подрывают доверие ко всему отчёту, даже если цифры верны.
Практические сценарии для работы и бизнеса
Теория полезна, но настоящая экономия начинается в конкретных задачах. Ниже несколько сценариев, которые я встречал чаще всего: они простые, повторяются регулярно и хорошо ложатся на связку «таблица плюс нейросеть».
Общий принцип одинаков: выгрузить данные, привести их в порядок, задать вопрос, получить черновик результата и проверить. Разница только в том, какие поля важны и какие выводы нужны на выходе.
Начните с одной задачи, которая отнимает больше всего времени. Не пытайтесь automate всё сразу: один отработанный сценарий даёт больше пользы, чем пять начатых и брошенных на середине.
Клиенты, продажи и заказы
В продажах нейросеть помогает свести историю клиента в одну строку: когда последний заказ, сколько всего купил, что обычно берёт, как давно молчит. Формула для такой сводки собирается за один запрос.
Дальше можно попросить сегментацию: активные, спящие, потерянные. Критерии вы задаёте сами, а модель помогает превратить их в правила и пометить каждую строку. Это основа для работы с клиентской базой.
Для анализа ассортимента полезно посмотреть, какие товары покупают вместе. Простая сводка пар «товар плюс товар» подсказывает идеи для комплектов, и нейросеть поможет сформулировать формулу для такой таблицы.
В работе с заказами часто нужно быстро найти проблемные позиции: просроченные, оплаченные но не отгруженные, с расхождением суммы. Опишите правила, и модель предложит формулу с несколькими условиями, которую останется только проверить.
Хорошо работает запрос на текст для клиента: напоминание о заказе, письмо после покупки, вежливое возвращение спящего клиента. Модель напишет черновик, вы подставите имя и детали, и на это уйдёт минута вместо десяти.
Не забывайте обновлять данные. Любая сводка устаревает в тот момент, когда её построили, поэтому договоритесь с собой о регулярности: раз в неделю, в один и тот же день, по одному и тому же шаблону.
Бюджет, время и планирование
В личных финансах таблица с расходами и нейросеть дают неожиданный эффект: вы начинаете видеть структуру вместо набора чисел. Модель помогает разложить траты по категориям и найти места, где бюджет утекает незаметно.
Загрузите выгрузку из банка, обезличьте её и попросите сгруппировать операции по смыслу. Формула или инструкция для категоризации сэкономит время, а сводная таблица покажет картину по месяцам.
В планировании проектов полезны простые расчёты: сколько задач в работе, что просрочено, какая загрузка у каждого исполнителя. Нейросеть подскажет формулу для статуса и поможет собрать короткий отчёт для команды.
Для личного времени работает тот же подход: таблица задач с датами и оценками, сводка по неделям, вопросы к данным. Через месяц накапливается статистика, по которой видно, куда уходит время на самом деле.
Если вы планируете закупки или загрузку, попросите модель помочь с простой моделью: средний расход, страховой запас, точка заказа. Формулы будут несложными, но вместе они дают систему, а не разовые решения.
И не усложняйте. Таблица на десять колонок, которой вы не пользуетесь, хуже таблицы на три колонки, которую вы заполняете каждый день. Начинайте с минимума, добавляйте поля только когда появляется реальный вопрос.
Типичные ошибки и как их избежать
Нейросеть в таблицах экономит время только тогда, когда вы ей не доверяете слепо. Я собрал ошибки, которые встречал у себя и у коллег, и почти все они связаны не с технологией, а с привычкой проверять.
Хорошая практика: относиться к ответу модели как к черновику от стажёра. Он старательный, быстро пишет, но может перепутать детали. Ваша задача — проверить и поправить, а не подписать сразу.
Ниже три главных источника проблем. Если держать их в голове, количество неприятных сюрпризов снижается в разы, а польза от ИИ становится стабильной.
Галлюцинации в цифрах и формулах
Модель может уверенно назвать сумму, которую не считала, или сослаться на функцию, которой не существует. Это не злой умысел, а особенность работы: она предсказывает правдоподобный текст, а не выполняет вычисления.
Поэтому любая цифра в ответе проверяется по таблице. Если модель говорит «итого примерно пятьсот», откройте файл и посчитайте. Расхождение сразу покажет, где ошибка — в формуле, в данных или в интерпретации.
С формулами проще: вставьте её в тестовый лист и сравните результат с ручным расчётом на пяти строках. Если сходится, применяйте ко всей колонке. Если нет, покажите модели оба результата и попросите найти причину.
Осторожно с функциями, которые «вроде бы есть». Модель может предложить новинку, недоступную в вашей версии Excel. Проверка на одном листе занимает минуту и снимает риск получить ошибку на весь отчёт.
И не просите считать в уме. Формулировка «посчитай сумму по этой колонке» почти гарантирует ошибку. Правильно: «напиши формулу, которая посчитает сумму по колонке C с условием по колонке A».
Если ответ выглядит слишком красиво и гладко, это повод насторожиться. Реальные данные почти всегда содержат огрехи, и честный анализ упоминает их, а не рисует идеальную картину.
Длинные таблицы и потеря контекста
Чем больше данных в сообщении, тем выше шанс, что модель упустит деталь. Она может забыть про условие из начала запроса или перепутать колонки, которые называются похоже. Это нормальное ограничение, а не сбой.
Решение простое: дробите задачи. Сначала разберитесь с одной колонкой, потом с другой. Каждый запрос должен касаться одного вопроса и одного набора данных, тогда ответы остаются точными.
Полезно нумеровать шаги. «Шаг 1: проверь формат дат. Шаг 2: найди строки, где дата раньше начала года» — такая структура помогает и вам, и модели не потерять нить.
Если данных действительно много, сначала постройте сводку в таблице, а в чат отправьте её. Агрегированные строки занимают мало места и содержат именно ту информацию, которая нужна для выводов.
Следите за названиями колонок в ответе. Если модель ссылается на «столбец с суммой», а у вас их два, уточните, какой именно имеется в виду. Двусмысленность — главный источник ошибок в длинных запросах.
И перезапускайте чат, когда задача меняется полностью. Старый контекст часто мешает: модель продолжает опираться на предыдущие данные, хотя вы уже работаете с другим файлом.
Когда лучше формула, а когда ИИ
Есть простое правило: если задача повторяется регулярно, нужна формула. Она работает без интернета, не требует оплаты и даёт одинаковый результат каждый раз. ИИ нужен, чтобы эту формулу создать, а не чтобы заменять её.
Если задача разовая и творческая — например, разобрать нестандартный текст или придумать структуру отчёта — лучше сразу идти в чат. Писать формулу под один случай обычно дольше, чем получить готовый результат вручную.
Для больших объёмов данных формула почти всегда выигрывает. Она обрабатывает тысячи строк за секунду, тогда как модель читает текст и теряет точность. Считайте в таблице, обсуждайте в чате.
Для объяснений и обучения лучше подходит ИИ. Он расскажет, почему формула работает, что означает каждая часть и как её изменить. Это особенно полезно, когда вы осваиваете новый инструмент.
Смешанный подход работает лучше всего: ИИ помогает спроектировать решение, таблица его выполняет, вы проверяете результат. Такая схема устойчива и не зависит от того, доступен ли сервис в данный момент.
И не бойтесь, что формула сложная. Если она сохранена и подписана, сложность не имеет значения. Значение имеет только то, что результат совпадает с реальностью и повторяется без вашего участия.
Как встроить работу с ИИ в ежедневный процесс
Самая большая ошибка после знакомства с нейросетями — использовать их от случая к случаю. Польза появляется, когда работа с ИИ становится привычкой: несколько минут каждый день, одна и та же последовательность действий.
Начните с малого: выберите одну регулярную задачу, которую делаете раз в неделю, и переведите её на новую схему. Например, подготовку сводки по заказам или проверку списка контактов перед рассылкой.
Через две недели вы заметите, что тратите на эту задачу меньше времени и меньше нервов. Тогда можно добавить вторую задачу. Такой постепенный подход надёжнее, чем попытка перестроить всё сразу.
Коллекция заготовок
Заведите файл с формулировками, которые сработали. Не просто «промты», а рабочие запросы с описанием структуры таблицы, условий и ожидаемого результата. Через месяц это ваша личная библиотека, которая экономит десятки минут.
Структурируйте её по задачам: чистка данных, формулы, анализ, отчёты, тексты для клиентов. В каждой папке — три-пять проверенных формулировок. Этого достаточно, чтобы закрывать большинство повторяющихся ситуаций.
Добавляйте к каждой заготовке короткую заметку: какие данные нужны, что проверять в ответе, какие были ошибки. Такая заметка полезнее самого запроса, потому что напоминает о подводных камнях.
Обновляйте библиотеку раз в месяц. Удаляйте то, что перестало работать, дописывайте новые варианты. Файл должен оставаться коротким и рабочим, иначе вы просто перестанете в него заглядывать.
Хорошо работает практика «одна задача — одна заготовка». Если запрос пытается решить сразу пять вещей, он превращается в мини-программу, которую сложно отладить и невозможно быстро адаптировать.
И делитесь заготовками с коллегами. Общий файл с формулировками ускоряет работу всей команды и заодно выравнивает качество: все используют проверенные подходы, а не изобретают свои с нуля.
План внедрения на неделю
Первый день: выберите одну задачу и выпишите, из каких шагов она состоит. Второй день: подготовьте обезличенную выгрузку и попробуйте первый запрос. Третий день: проверьте результат и исправьте формулировку.
Четвёртый день: оформите рабочий вариант в виде заготовки и сохраните. Пятый день: примените её к новым данным без подсказок, чтобы понять, где ещё остались непонятные места. Шестой: покажите коллеге и соберите замечания.
Седьмой день оставьте на отдых от новой схемы. Важно не превращать внедрение в марафон: устойчивая привычка появляется, когда процесс не требует героических усилий и вписывается в обычный рабочий ритм.
К концу недели у вас будет одна работающая связка «таблица плюс ИИ» и понимание, куда двигаться дальше. Этого достаточно, чтобы через месяц захотеть вторую, а через квартал — перестроить заметную часть рутины.
Не стремитесь к идеалу с первого раза. Первая версия почти всегда кривая, и это нормально. Важно, что она уже экономит время, а улучшения можно вносить постепенно, по мере появления реальных задач.
И фиксируйте результат. Простая заметка «раньше уходило два часа, теперь сорок минут» — лучший аргумент для себя и для руководства. Без такого учёта польза кажется, но не доказывается, и мотивация быстро гаснет.
В итоге вся эта история не про волшебные кнопки, а про дисциплину. Нейросеть даёт черновик, таблица даёт точность, а вы даёте смысл. Вместе получается рабочий процесс, который выдерживает и авралы, и скучные будни.
Начните с одной таблицы, которая давно раздражает. Скорее всего, уже через вечер вы будете смотреть на неё спокойно, а через неделю забудете, как это раньше занимало столько времени.
И помните: инструменты меняются, привычка проверять и думать остаётся. Она и есть главный навык работы с данными в эпоху нейросетей — всё остальное приложится по мере практики.
Отдельно стоит сказать про обучение. Работа с таблицами через нейросеть учит формулировать задачи точнее, и этот навык переносится далеко за пределы Excel. Вы начинаете замечать, где в постановке задачи не хватает данных, а где вы просите невозможное.
Кроме того, такой подход снижает страх перед сложными инструментами. Многие годами обходят сводные таблицы стороной, потому что когда-то не разобрались в интерфейсе. С нейросетью барьер исчезает: можно спросить простыми словами и получить понятный ответ.
Есть и обратная сторона: привычка спрашивать всё подряд делает мышление ленивее. Поэтому я стараюсь чередовать — половину задач решаю сам, а ИИ подключаю там, где он действительно быстрее. Такой баланс сохраняет навык и экономит время.
Через несколько месяцев такой практики вы заметите, что стали лучше понимать свои данные. Не потому, что нейросеть стала умнее, а потому, что вы научились задавать правильные вопросы и проверять ответы. Это и есть настоящий результат.
Если вы дочитали до конца, у вас уже есть план: выбрать задачу, подготовить данные, сформулировать запрос, проверить результат и сохранить удачную заготовку. Дальше дело только за первым шагом, который занимает меньше времени, чем чтение этой статьи.
Комментарии